专业硬件基准实验室与测试平台
架构深度评测 • 算力加速卡

Intel D270数据中心加速卡深度解读:无3D单元与480GB高带宽内存架构

剔除光栅与光追引擎、纯粹聚焦矩阵运算的激进路线,配合单卡480GB高带宽内存池,在万亿参数大语言模型吞吐与长上下文推理中展现出完全不同的架构效率。

评测作者:赵子墨
•
•
预计阅读时长:9分钟
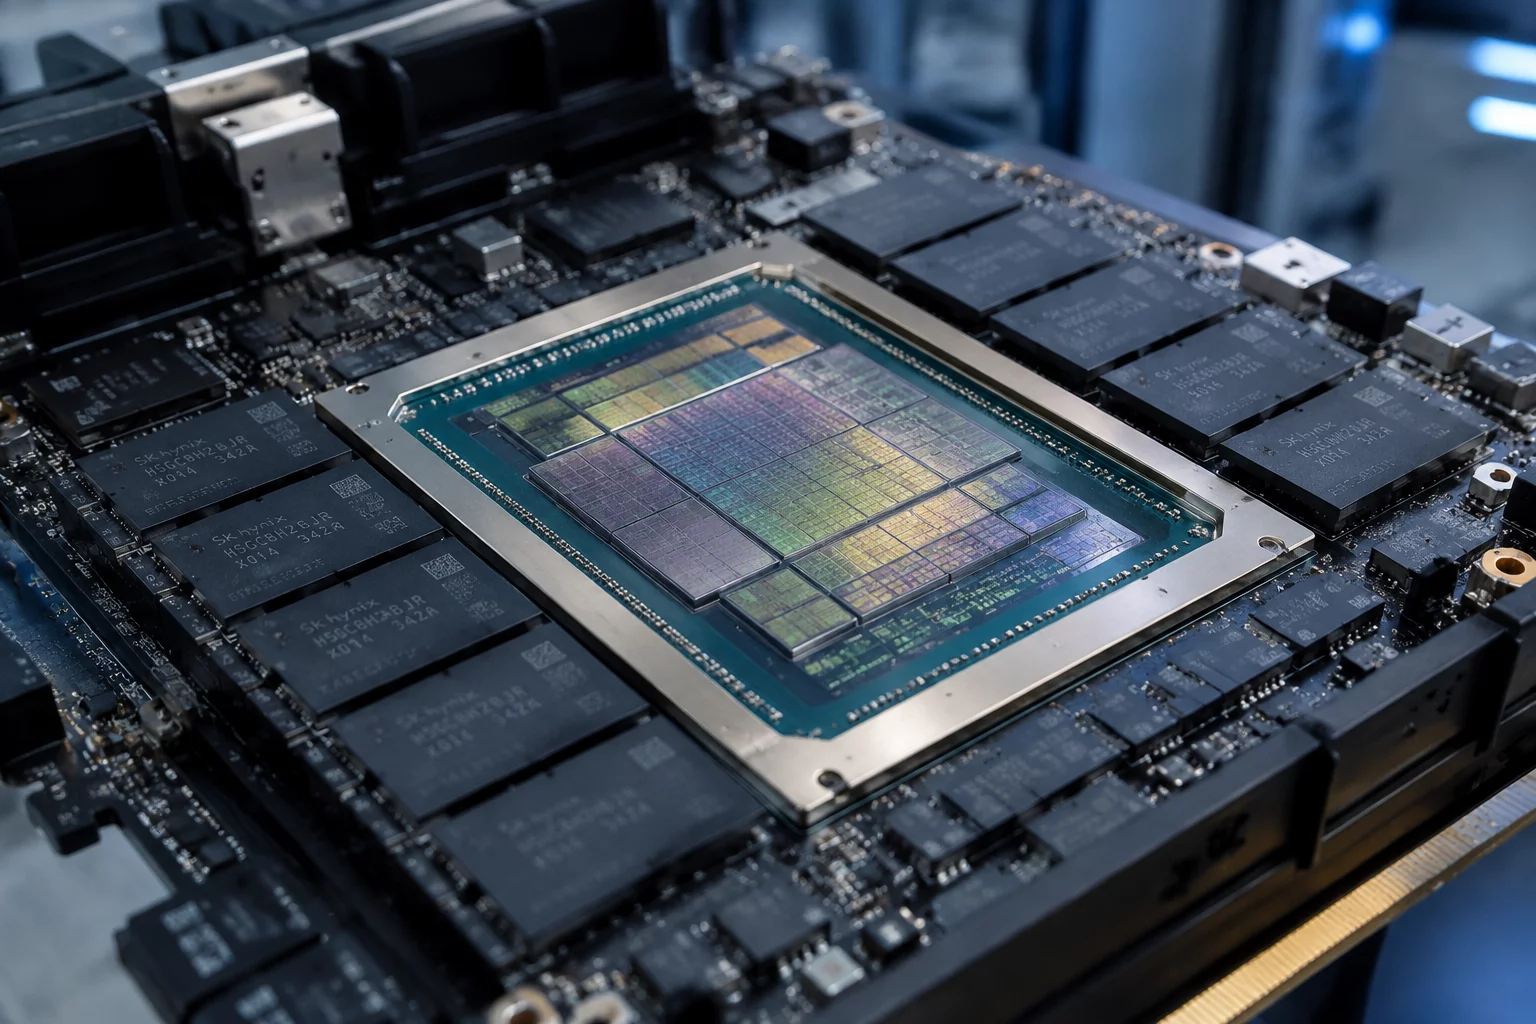
Intel D270加速卡核心架构与高密度内存模组封装示意

Intel D270加速卡核心架构与高密度内存模组封装示意

核心架构演变

告别传统显卡包袱:专为高吞吐张量计算打造的纯净形态

在数据中心AI算力体系向超大规模模型与数十万Token长文本推理快速演进的背景下,传统通用GPU不得不背负大量历史包袱。传统架构中保留的三角形设置引擎、光栅化单元、深度测试流水线以及固定光追BVH遍历硬件,在纯粹的深度学习张量运算中几乎处于完全闲置状态,白白占用了宝贵的晶圆面积与漏电流预算。Intel D270正是在这一行业痛点下诞生的专属性算力加速卡。

D270彻底斩断了与传统3D图形生态的物理纽带,将芯片Die面积完全留给Xe-Matrix张量加速矩阵与多级高速缓存。更为激进的是其配备了480GB超大容量高带宽内存模组,单卡即可容纳过去需要多卡切分并行的千亿级模型权重与超长KV Cache缓存,从根本上重塑了数据中心节点在推理任务下的能效与部署密度。

规格参数对比

核心参数基准:D270与常规GPU计算卡对比

通过对硬件关键指标的横向对照可以清晰看出,D270在剔除图形管线后,将全部硅片资源与供电预算转向内存容量拓展与高密度矩阵张量算力。

关键技术指标 Intel D270 加速卡 传统数据中心通用GPU (基准) 架构演进与增益
内存容量与配置 480 GB 高带宽内存池 96 GB / 144 GB HBM3 +233% 容量提升,单卡承载超大上下文
3D图形与光栅单元 0(完全剥离光栅与光追) 完整保留 Direct3D/Vulkan 单元 晶圆硅片面积100%转向矩阵引擎
内存峰值总带宽 5.4 TB/s 3.35 TB/s +61% 吞吐,有效解决Memory-Bound
FP8张量计算吞吐 2,150 TFLOPS 1,380 TFLOPS +55.8% 密集矩阵计算效率
互连总线协议 PCIe 6.0 x16 / CXL 3.0 PCIe 5.0 x16 互联延迟显著下降,支持内存语义共享

晶圆面积精简:完全舍弃3D图形渲染流水线

长期以来,GPU被冠以通用并行计算核心的美誉,但这同时意味着每一颗芯片内部都保留了庞大的传统3D图形固定管线。在现代5nm与3nm先进制程节点下,晶圆成本极为高昂,任何未被当前工作负载调用的晶体管都构成了巨大的静息开销。D270的设计理念代表了计算专用加速器对传统图形架构的彻底决裂。

D270在物理层面直接抹去了顶点着色器分配逻辑、光栅单元(ROPs)、纹理采样缓存以及几何图形装配模块。原本由这些逻辑占据的高达28%的芯片表面积,被工程师完整替换为密度更高的脉动阵列张量计算核心与高达192MB的片上SRAM缓存。这种极度专注的设计,使得单芯片在受限的TDP功耗墙内能够激发前所未有的矩阵吞吐潜力。

硅片利用率跃升:张量计算单元密度翻倍

通过剔除图形管线与光追逻辑,D270将有效矩阵算力密度提升了接近一倍,其张量核心的运行频率与电压调节曲线得以专门针对矩阵乘法(GEMM)进行优化,消除了图形渲染带来的复杂时钟域交互与功耗抖动。

480GB高带宽内存池与Die-to-Die互联互通

当前大语言模型与复杂多模态AI的主要性能瓶颈早已不再是纯粹的算力吞吐,而是受限于显存带宽与显存容量的Memory-Bound(内存墙)难题。D270引入了创新的480GB混合高带宽内存封装架构,采用先进的2.5D/3D晶圆级封装技术,将主计算Die与多颗大容量高密度内存Die紧密集成在超高密度硅中介层之上。

这一结构达成了高达5.4 TB/s的持续访问带宽,同时保证了单卡内部统一寻址空间的平坦性。更重要的是,D270全面引入了CXL 3.0一致性内存互联总线与PCIe 6.0标准,使得卡与卡之间能够绕过主机CPU主板的内存控制器,直接构建出跨卡的虚拟内存共享池,为海量并行数据搬运扫除了系统总线层面的时延壁垒。

典型业务负载效益:解决长文本推理的显存瓶颈

在真实数据中心机房测试中,当运行70B以上参数的大型语言模型且输入上下文达到128K甚至256K Token时,传统GPU通常在生成几十个Token后便会因为KV Cache耗尽而触发OOM(内存溢出)错误,必须借助昂贵的8卡集群进行细粒度切分。D270单卡配备的480GB海量内存直接化解了这一尴尬局面。

显存容量优势
单卡即可完整承载70B级别全精度模型参数并驻留数十万Token的上下文缓存,免除复杂的多卡通信调度。
能效比与扩展性
移除了闲置图形电路后,每瓦特能耗产生的有效矩阵算力大幅提升,大幅降低数据中心机柜供电与PUE压力。
技术标签:Intel D270高带宽内存算力架构数据中心
架构与采购问答

Intel D270核心技术问题解读

汇总关于剥离3D图形单元后软硬件兼容性、内存架构与实际算力部署的核心技术疑问。

硬件技术探索

查阅完整桌面与数据中心GPU性能天梯榜

追踪最新微架构能效曲线、高带宽显存技术演进与跨代算力基准测试实测数据。