一、3GB GDDR7非二项进制颗粒在256-bit总线架构下的物理成真
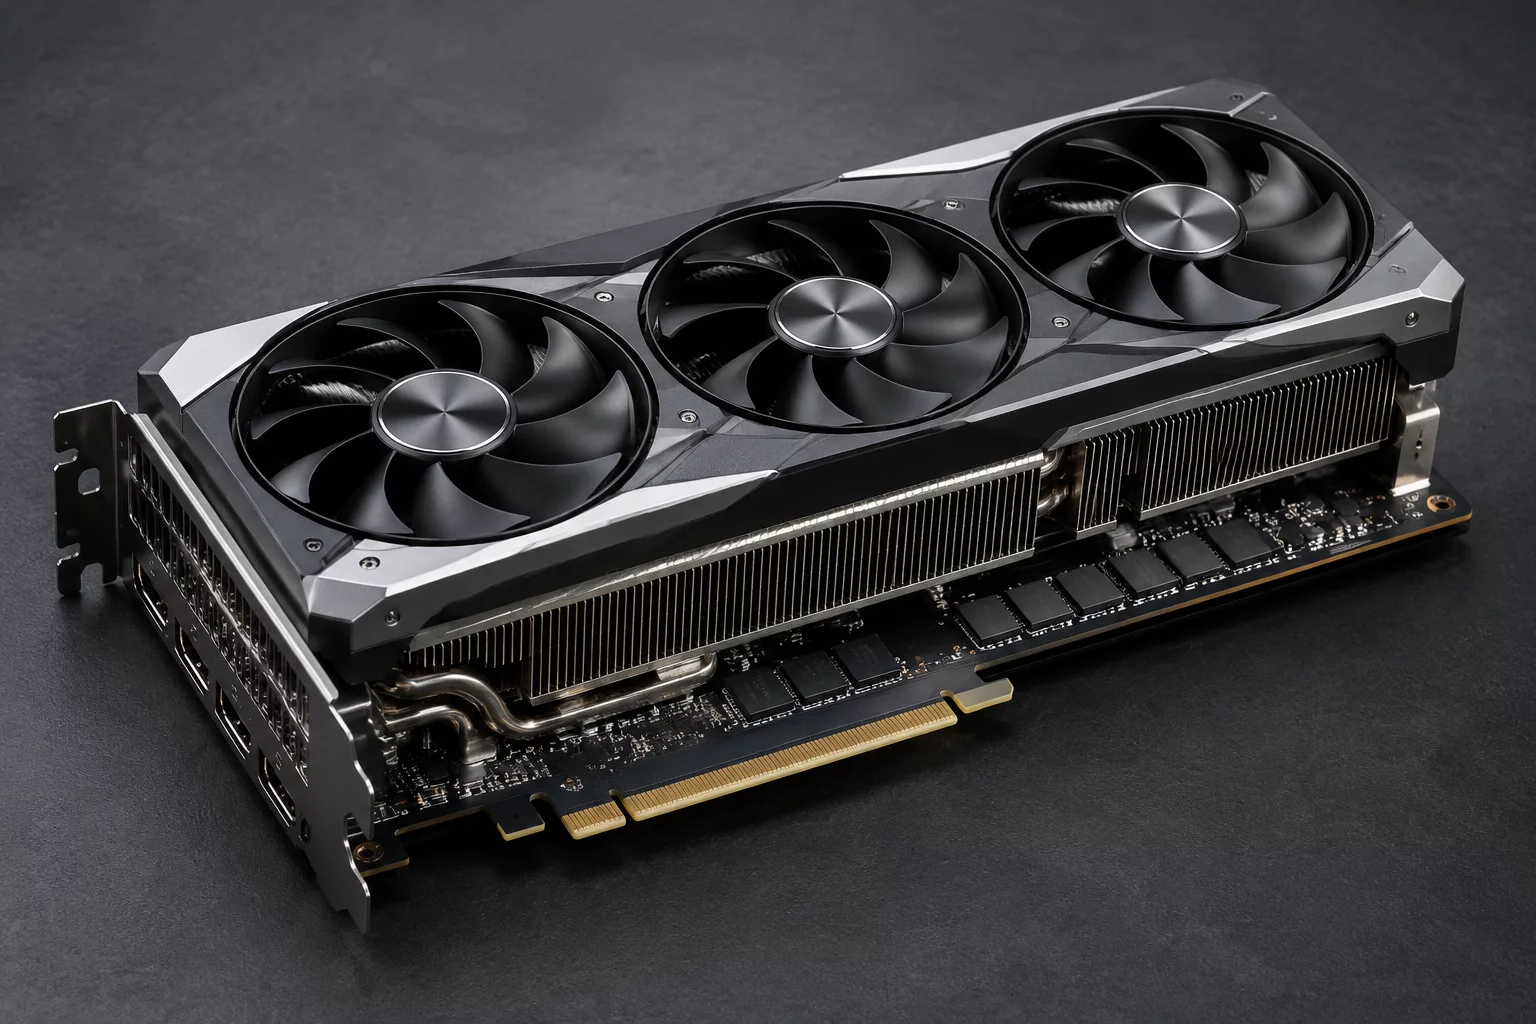
长期以来,GPU显存的容量提升通常受限于严格的二项进制规律(例如从16GB跃升至32GB通常需要384-bit或双面夹心贴片布局)。然而在下一代Blackwell消费级架构中,3GB密度(24Gb)GDDR7颗粒的引入彻底重塑了布线方案。在维持原有256-bit位宽的前提下,显卡仅需排布8颗显存即可达成24GB的黄金规格,而无需采用会显著恶化背面发热与布线阻抗的Clamshell(正反贴)设计。
这种布线方案保证了PCB走线的等长高完整性,使得GDDR7能够在PAM3信号调制模式下稳健运作于30 Gbps以上的高频,总带宽直逼接近1TB/s门槛。这使得高带宽与高容量在次旗舰卡上达成了均衡共存。
显存控制器与内存映射机制优化点
非二项进制颗粒要求显卡内置的显存控制器必须具备灵活的寻址映射单元。通过在固件微码层调整跨通道行地址周期分配,该架构消除了以往非对称扩容可能引起的局部带宽惩罚,确保全部24GB显存空间具备均匀一致的读写延迟表现。
二、高负载本地AI量化推理与重度3D视效制作的吞吐提升
对于内容创作者和本地AI工程师而言,16GB显存与24GB显存的体验差距往往不是帧率高低,而是任务“能运行”与“直接报错崩盘(OOM)”的区别。在本地部署32B参数规模的量化大语言模型或执行长上下文注意力缓存时,16GB显存往往在加载系统提示词后便已濒临溢出,严重依赖系统内存虚拟置换,导致Token生成速度出现断崖式下跌。
当显存扩容至24GB后,整套KV Cache以及上下文扩展窗口可以完全常驻于高速GDDR7物理颗粒中。在虚幻引擎5复杂场景实时烘焙以及Blender大型几何体位移映射测试中,显存利用率跨过18GB之后,RTX 5080 24GB仍能维持满血核心频率运作,避免了PCIe总线频繁拷贝带来的性能损耗。
三、受众适配分析:谁是RTX 5080 24GB的核心目标群体?
硬件规格的调整不可避免带来物料成本的变动。24GB版本并非定位于所有普通电竞玩家,而是精准切入对硬件有严苛功能性要求但又受限于旗舰卡昂贵售价的细分领域: