专业硬件基准实验室与测试平台
微电子先进封装技术

先进微电子封装在高性能计算硬件中的互连技术趋势

面对先进制程光罩尺寸红线与能效墙挑战,2.5D硅中介层与3D直接混合键合等高密度微互连拓扑,正在重塑现代HPC与AI处理器的算力天花板。

评测作者:赵子墨
•
•
预计阅读时长:8分钟
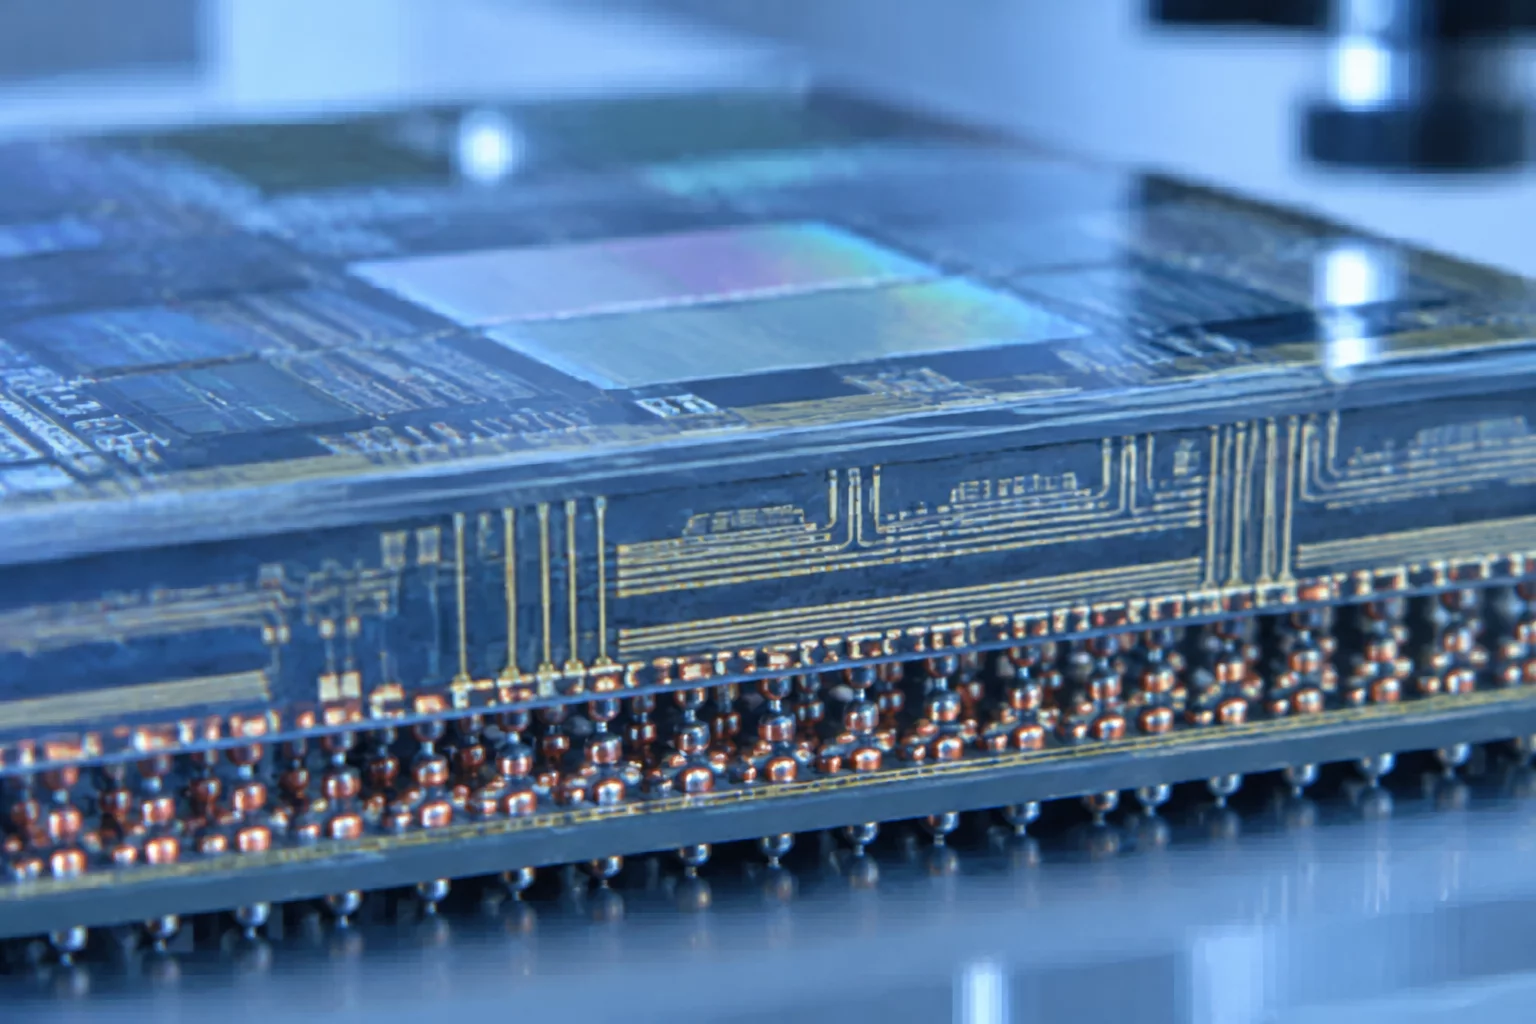
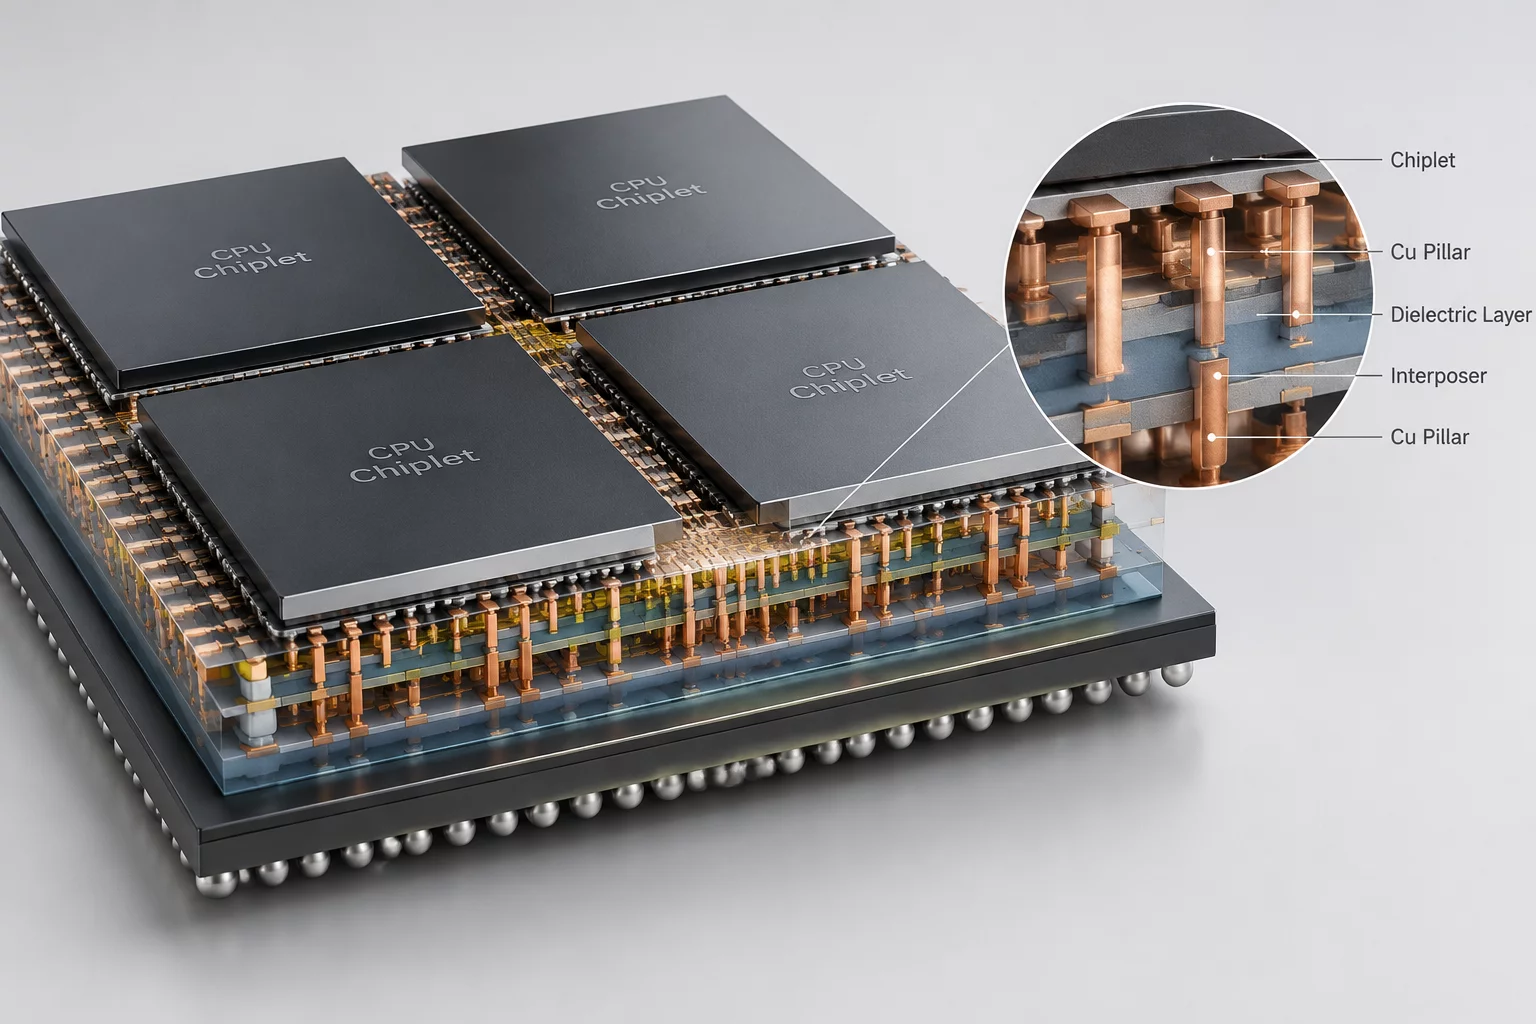
先进微电子封装高密度硅中介层与微凸块互连显微切片结构示意

先进微电子封装高密度硅中介层与微凸块互连显微切片结构示意

异构互连演进背景

打破内存墙与光罩极限:从单芯片缩放到多芯粒协同互连

随着前沿半导体光刻制程逼近原子级物理极限,单颗晶圆裸片(Die)的面积已很难超越标准曝光光罩的面积阈值。高性能计算(HPC)与超大参数模型训练集群所渴求的吞吐量,直接倒逼硬件工程师通过异构芯粒(Chiplet)将算力核心与高带宽显存(HBM)在封装层面高密度拼装。微电子封装不再仅仅是保护芯片和引脚转换的物理外壳,而是变成了承载千兆字节吞吐的微型高速主板。

在当前的工程实践中,互连线宽与微凸块间距的持续压缩,带来了前所未有的电磁耦合、信号完整性劣化与局部热应力挑战。理解中介层材质差异、垂直通孔(TSV)阻抗控制以及每比特传输能耗指标,已成为评估现代服务器GPU、AI专用加速芯片及高端工作站处理器的关键硬核维度。

关键技术指标横向比对

主流微电子封装互连拓扑电气与物理参数对比

下表汇总了当前高性能计算硬件从成熟有机基板倒装,到2.5D硅中介层,再到前沿3D晶圆级直接混合键合的关键工程参数量化实测区间。

关键参数与电气特性 3D晶圆级直接混合键合 2.5D硅中介层 (CoWoS/EMIB) 传统有机基板倒装 (Flip-Chip)
接触互连节距 (Pitch) < 0.9 μm 无凸块熔接 35 - 45 μm 微凸块 110 - 130 μm 标准焊球
有效面互连密度 (I/O每平方毫米) > 1,200,000 / mm² 1,200 - 3,200 / mm² 80 - 160 / mm²
单位比特传输能耗 (Energy/Bit) 0.03 - 0.08 pJ/bit 0.45 - 0.95 pJ/bit 3.20 - 4.80 pJ/bit
芯片间信号往返延迟 (RC Latency) < 1.2 ns 3.8 - 6.5 ns 18.0 - 26.0 ns
热应力失配公差与制造良率门槛 极高:需化学机械纳米抛光 高:需大尺寸中介层翘曲控制 成熟:热膨胀系数匹配容限大

2.5D中介层与3D混合键合的拓扑差异与物理极限

在2.5D微电子封装拓扑中,计算核心与高带宽显存芯片水平并排安置在同一块无源或有源硅中介层上。中介层内部依靠微米级亚细走线(Line/Space常小于0.8μm/0.8μm)构成多层重布线网络(RDL)。这种结构极大缩减了各芯粒间的物理走线距离,绕过了传统印刷电路板(PCB)高介电损耗与大寄生电容对高速信号的遏制。然而,随着接入HBM堆栈数量由4组攀升至8组甚至12组,中介层自身的面积往往达到曝光视场的3.5倍以上,给制造带来了严重的硅片缺陷聚集与拼版对准公差。

为了冲破平面尺寸扩张的枷锁,3D晶圆级直接混合键合(Direct Hybrid Bonding)应运而生。该工艺不再依赖任何易熔锡焊料微凸块,而是直接在超平整晶圆表面制备纳米级铜焊盘,在分子级洁净室中通过铜-铜金属界面扩散与介质层分子键合实现无缝融合。垂直穿硅通孔(TSV)在此架构下可以将信号传输通道缩短至数微米级别,几乎彻底消除互连电感,使芯粒间数据交换的延迟表现逼近单芯片片内总线水平。

材料热膨胀系数(CTE)与封装翘曲的工程矛盾

硅材料的CTE约为2.6 ppm/°C,而底部有机载板的CTE则通常高达14-17 ppm/°C。在芯片经受数千次热循环与瞬态大负荷切换时,巨大温差导致的热机械剪切应力极易在中介层边缘与微凸块结合处诱发微裂纹。高可靠性封装要求设计团队使用具有精确填料配比的底部填充胶(Underfill),并在芯片边缘布置应力缓冲假焊盘。

信号完整性与供电网络(PDN)阻抗的协同优化

高密度互连线网在带来超大聚合吞吐的同时,也带来了严重的电磁串扰隐患。亚微米级布线间距使得相邻信号线之间的互感与电容耦合呈指数级放大,工程师必须引入差分共面波导(CPW)与交替地线屏蔽层来抑制高频远端串扰。与此同时,在千兆赫兹级有效数据率下,导体表面的趋肤效应使得铜走线的微观粗糙度控制成为决定信号眼图张开度的决定性指标。

更为严峻的挑战来自于供电网络。现代HPC处理器的峰值运行电流轻松突破1000安培,而瞬态动态功耗波动速率(di/dt)往往高达上万安培每微秒。传统通过主板供电再经基板传输的供电路径,其寄生回路电感足以引起灾难性的IR压降与电压纹波塌陷。当前的封装前沿趋势是通过深沟槽电容(DTC)与集成稳压电路(FIVR)直接嵌入硅中介层内部,将高频储能去耦电容放置在距离核心晶体管仅数微米的垂直位置,有效将目标阻抗压制在毫欧级安全区间。

硬件架构选型:热预算瓶颈、可制造性与成本权衡

在系统架构选型阶段,互连密度并非唯一决定指标。3D垂直堆叠虽然具备极低互连能耗与极短延迟,但底部计算核心的热量必须穿透顶部芯片或硅衬底才能导出,极高的体积热流密度给散热模组提出了严酷考验。硬件工程师需要根据产品的算力形态与热设计功耗(TDP)预算做出清晰的架构分流:

2.5D 平面异构中介层方案
适合AI大模型训练显卡与异构通用算力卡。芯片在水平方向延展,便于整面均热板(Vapor Chamber)贴合与直接冷板液冷实施。供应链成熟度与最终测试成品率较高,综合边际生产成本更容易受控。
3D 晶圆级直接键合堆叠方案
适合追求超大容量低延迟三级/四级缓存扩展的服务器CPU或极致高密度类脑芯片。其对晶圆平整度与洁净度容错率为零,且必须配套微通道浸没式或双面液冷散热工程,适用于成本不敏感的顶尖算力节点。
技术标签:2.5D封装中介层3D直接混合键合Chiplet多芯粒互连穿硅通孔TSV技术
常见技术疑点解答

关于先进微电子封装在HPC硬件应用的深度问答

针对高性能硬件工程师与资深硬件玩家关心的封装互连瓶颈、良率难题及标准协议做出一对一解答。

拓展阅读研讨

相关硬件核心架构解析与制造生态专栏

了解前沿半导体光刻产能、液冷散热架构及工作站统一内存形态的系列技术专文。

实测基准对照

查阅最新桌面与工作站GPU基准性能数据库

了解多款高规格显卡在极限功耗、温控表现与真实渲染负载下的实际运行性能,参考Viewglobe独立测试实验室的第一手量化基准。