物理层拓扑解析:异构核心一致性缓存与零拷贝机制
RTX Spark平台的核心优势在于其片内互连架构。不同于传统通过主板走线和PCIe插槽传输数据的方式,该平台将ARM通用计算集群与Blackwell架构图形计算单元整合在统一封装中。两者通过高密度硅基互联桥直接与统一内存控制器通信,在硬件层面上实现了内存一致性(Cache Coherency)。
在驱动程序层面,开发者无需再调用显存分配指令在系统内存与专用显存之间来回倒腾缓冲区。只要应用程序申请了内存指针,图形核心与通用计算核心便能同时对其执行原子操作,数据准备时间几乎缩短为零。
零拷贝(Zero-Copy)对生成式AI带来的质变
在70B参数规模的大语言模型或密集型扩散模型本地部署中,整机可用的128GB统一内存能够将模型权重全部载入同一连续地址空间,完全避免了传统双卡NVLink或显存切片导致的通信瓶颈,单机即可跑通此前需要企业级工作站才能承载的微调任务。
实测性能验证:Blender渲染与复杂多轨后期表现
在实际工程场景测试中,我们加载了一个包含数千万多边形和复杂程序化材质的高精度汽车装配体场景。在传统16GB显存环境下,该工程在开启视口渲染时会立刻触发显存溢出回退机制,导致系统出现卡死。而在ProArt RTX Spark工作站上,系统平稳调度了多达64GB的统一物理内存,视口光线追踪以流畅帧率即时生成。
视频剪辑方面,在面对8K 60fps ProRes 422 HQ多轨工程时,解封装器与特效管线共享同一帧缓冲区,无需重复解码拷贝。时间线拖拽定位和色彩调色几乎实现了零缓冲延迟,工作流程的连续性获得了显著提升。
能效与形态革命:紧凑散热下的持续性能释放
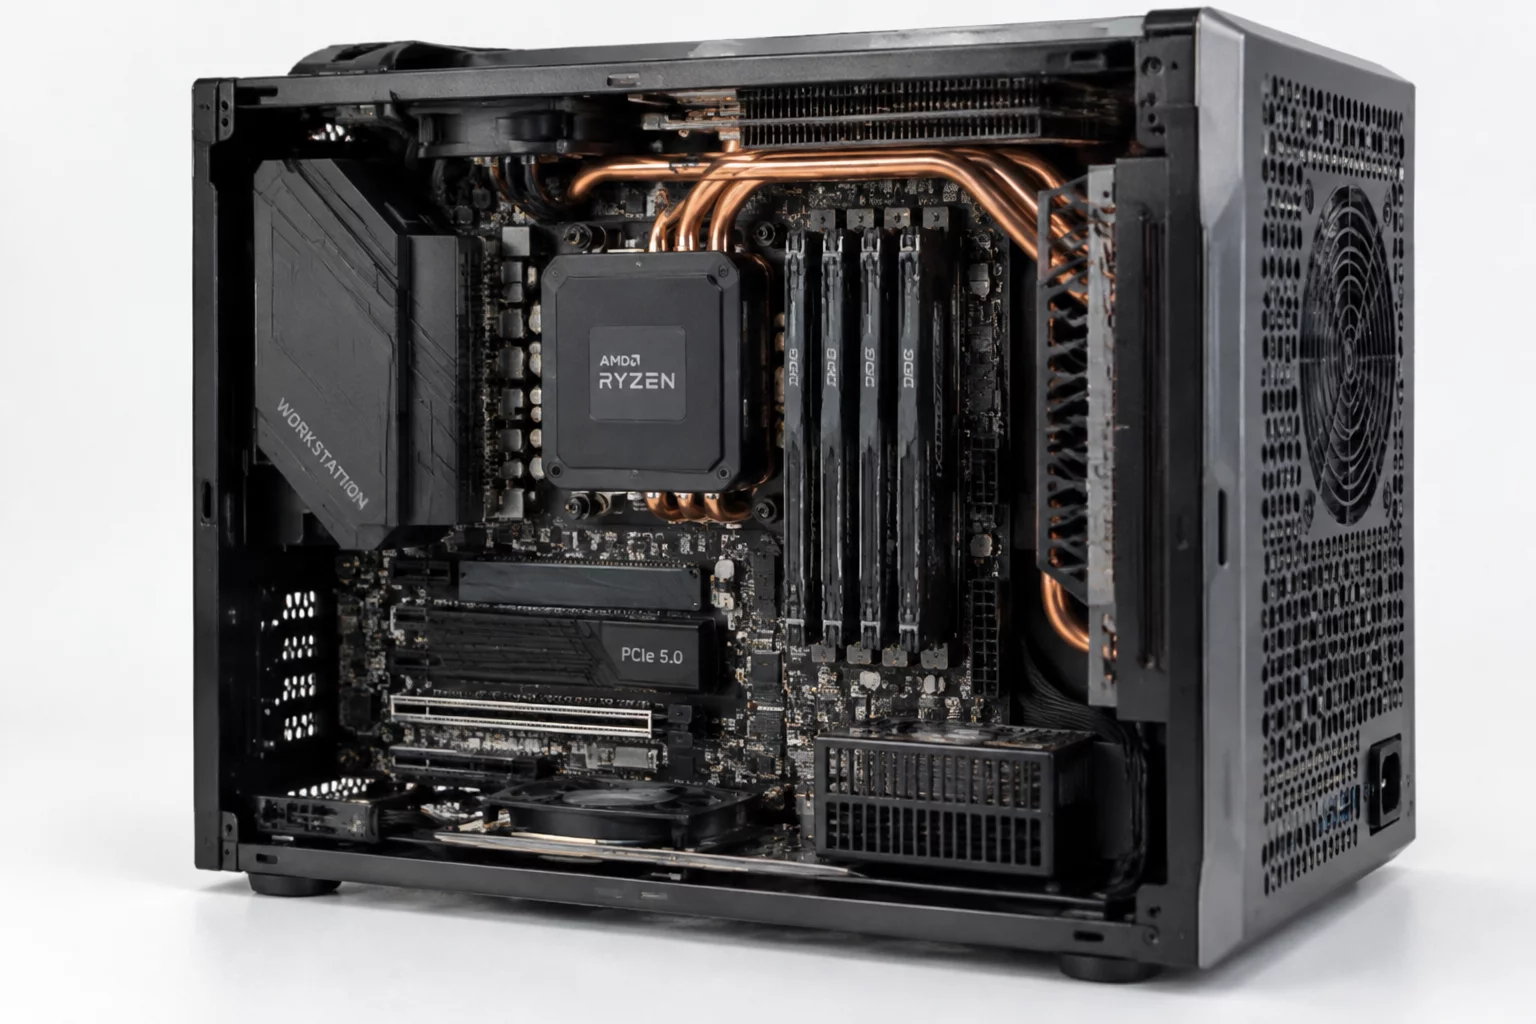
由于大幅缩减了显存颗粒与外围供电电路的数量,ProArt工作站的主板布局得以极度紧凑化。机箱内部风道可以集中服务于中央均热板与高效离心涡轮风扇,使得整机即使在双烤满载状态下,噪声也稳定控制在32分贝以下,非常契合专业录音棚与设计工作室对安静环境的严苛要求。
架构核心优势
突破传统显存容量上限,实现超大规模数据零拷贝吞吐;低功耗表现带来桌面工作站形态的极致小型化。
适用人群与局限
极其适合大模型本地开发者、三维视效工程师和超高清视频创作者;对于强依赖传统x86专有指令集的老旧工程软件则需通过兼容层运行。