COMPUTEX 2026自主AI代理硬件架构展示
COMPUTEX 2026 前沿架构观察

COMPUTEX 2026聚焦本地自主AI代理硬件重构与架构革新

从被动指令交互迈向全天候常驻行动体,个人电脑主板拓扑、互联带宽与能效管理正在迎来底层重构,芯片组与供电系统全面转向自主代理闭环支持。

评测作者:李明轩
•
•
预计阅读时长:8分钟
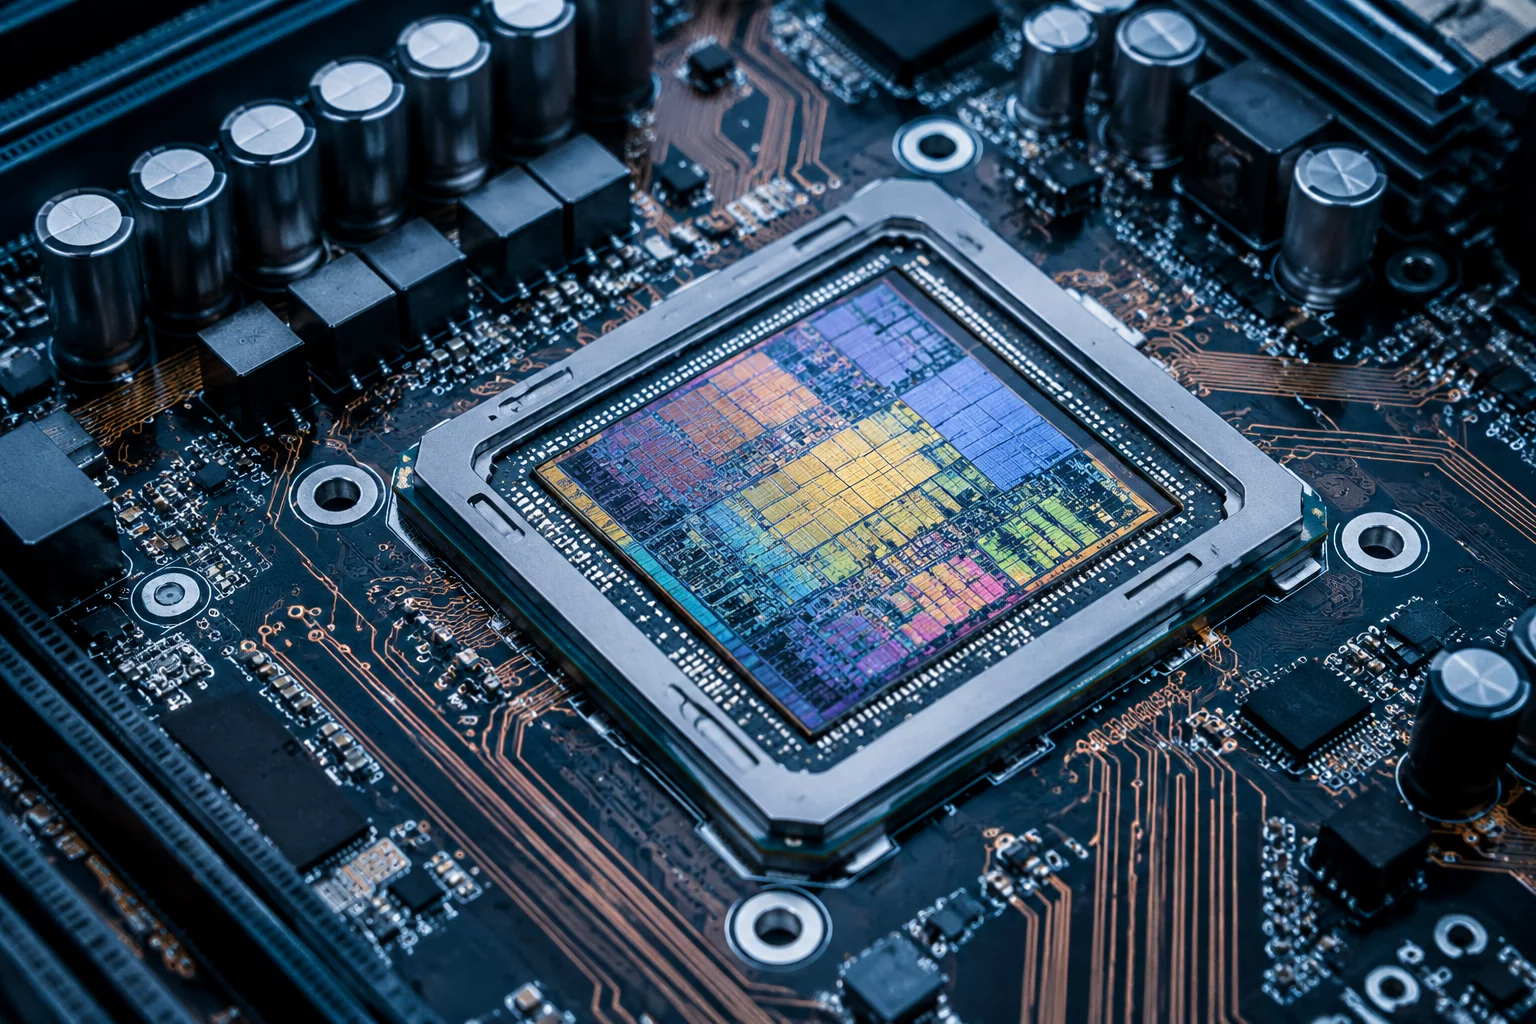
高密度芯片封装与板载总线走线微距特写

COMPUTEX 2026展示的全新高通量互连总线与AI代理专用SoC板级走线架构

行业演进综述

自主运行模型常驻推动PC底层物理架构洗牌

在过去两年中,消费级PC对人工智能的处理主要集中在单次被动生成和云端离散调用上。随着COMPUTEX 2026现场多家顶级芯片制造商与主板大厂密集发布全新产品线,硬件设计的重心已不可逆转地转向了“本地自主AI代理(Autonomous AI Agent)”。这类自主程序不再等待用户逐条敲入Prompt,而是在系统底层持续监控多模态输入、自主规划长链条任务并直接调用操作系统底层API。

这一范式迁移直接击穿了传统x86主板与分立显卡的协作瓶颈。当Agent每秒需要执行数十次上下文回溯、短时工作记忆持久化以及低延迟工具调用时,跨PCIe总线的显存数据搬运会造成致命的功耗激增与总线拥塞。本届展会上展出的新一代硬件方案,彻底推翻了过往依靠单体狂飙算力的思路,全面转向统一共享寻址内存、常开低功耗微计算单元以及高响应率供电调节机制。

硬件参数基准

自主AI代理平台与传统AI PC硬件指标对比

COMPUTEX 2026现场公布的行业白皮书确立了针对自主行动代理系统的基础硬件标准,在核心内存位宽、待机推理功耗与互联拓扑上均发生了显著跨越:

核心架构维度 COMPUTEX 2026 代理专用架构 2024-2025 初期 AI PC 基线 硬件升级幅度
常驻模型推理系统内存带宽 512 GB/s - 1024 GB/s 统一寻址 85.3 GB/s (常规双通道DDR5) 提升 6.0x - 12.0x
本地微代理待机运转功耗 2.5W - 6.0W 持续监听推理 28W - 45W (GPU唤醒待机状态) 能耗降低 82%
板级总线互联协议 PCIe Gen6.0 x16 + CXL 3.1 内存池化 PCIe Gen5.0 离散直连 吞吐翻倍且支持无锁内存借用
低延迟上下文唤醒时间 < 12ms (直达神经算力岛) 180ms - 320ms (驱动唤醒延迟) 响应延迟缩短 93%
主板VRM供电瞬态响应容差 1200A/μs 超宽频数字供电回路 400A/μs 阶梯式电源响应 瞬态承载能力提升 3.0x

统一物理内存总线与CXL 3.1共享存储池

自主Agent与传统对话机器人最大的不同在于“环境感知与工具调用的频繁性”。当Agent在本地自主运行时,它需要时刻维系几万甚至几十万Token长度的动态工作记忆(Working Memory)。如果采用传统的“系统内存先加载、再通过PCIe拷贝至独显显存”的传统通路,每次Agent触发外部工具时都会产生严重的显存换页惩罚。

在本届展会上,包括华硕、微星和技嘉展示的新一代发烧级与工作站主板,普遍引入了基于CXL 3.1协议的近处理器内存扩展接口,以及采用LPDDR5X/LPDDR6板载超宽总线的统一内存形态。CPU、低功耗Agent加速芯片与大算力GPU能够直接共享同一个高带宽物理地址空间,消除了内存副本拷贝带来的几十毫秒延迟,使得微模型能够在毫无感知的情况下瞬间读取系统屏幕帧缓冲与进程状态。

现场技术亮点:零拷贝内存锁消除机制

各厂商展示的统一内存控制器集成了新型硬件哈希寻址引擎,允许后台推理单元以只读无锁模式直接巡检应用进程上下文,不仅保护了数据一致性,更将本地推理数据流准备阶段的CPU占用率从原本的18%压降至不足1.5%。

异构NPU常驻核心:告别高功耗显卡待机

如果全天候开启一块TDP高达300W甚至450W的旗舰独显来维持AI代理的轮询,整机功耗与噪音根本无法被桌面用户接受。COMPUTEX 2026上显卡与处理器厂商达成的最大默契,正是“分级执行体”概念的落地:70亿参数以下的轻量感知代理模型被完整下放至常驻主板或芯片组内部的微型NPU岛中运行。

这种低功耗NPU岛通常功耗仅为3W至5W,具备独立的超低压供电相,即便整机处于深度睡眠S3模式,它依然可以通过专有安全总线抓取网络数据包和系统事件。只有当需要进行大型复杂代码合成或多模态渲染决策时,微型NPU才会通过硬件中断唤醒高性能GPU介入,从而在保证Agent“永远在线”的同时维持极佳的整机能耗比。

微秒级突发负载下的供电与分层散热挑战

传统计算负载在重载与轻载之间的转换往往存在阶梯式的爬升时间,而本地自主Agent的推演通常是高频密集的微脉冲结构:在持续10毫秒的思考判断期内算力单元拉满至顶峰,随后数十毫秒内等待外部API反馈又迅速归零。这种极端的负载波动对供电VRM的瞬态响应速度提出了近乎苛刻的要求。

主板供电拓扑升级
大量主板采用了背置多相数控供电芯片与钽聚合物电容阵列,将VRM电压纹波响应时间从以往的微秒级别压缩到纳秒区间,以防止突发Agent密集推理引起的掉压死机。
分层冷排与相变材料应用
散热方案不再只针对单一核心导热,而是为芯片组内部的NPU、主控和高带宽内存设计了独立的微相变均热板,保证在风扇停转的静音模式下维持长期稳定排热。
技术标签:COMPUTEX2026自主AI代理统一内存架构CXL3.1互联
常见疑问解答

关于本地自主AI代理硬件重构的深度解答

针对本次COMPUTEX 2026展示的硬件新标准,我们整理了玩家与硬件技术极客最为关心的三大核心疑问:

延伸技术解析

探索更多计算芯片与前沿硬件架构专题

结合COMPUTEX 2026现场热点,推荐阅读以下关于新型统一内存SoC、液冷温控和工业互联架构的专业剖析:

GPU与硬件算力天梯

查阅最新桌面GPU在本地AI生成与游戏负载实测表现

前往Viewglobe显卡评测中心,查看涵盖主流架构显卡的每瓦算力、模型推演吞吐量及每帧综合成本数据。